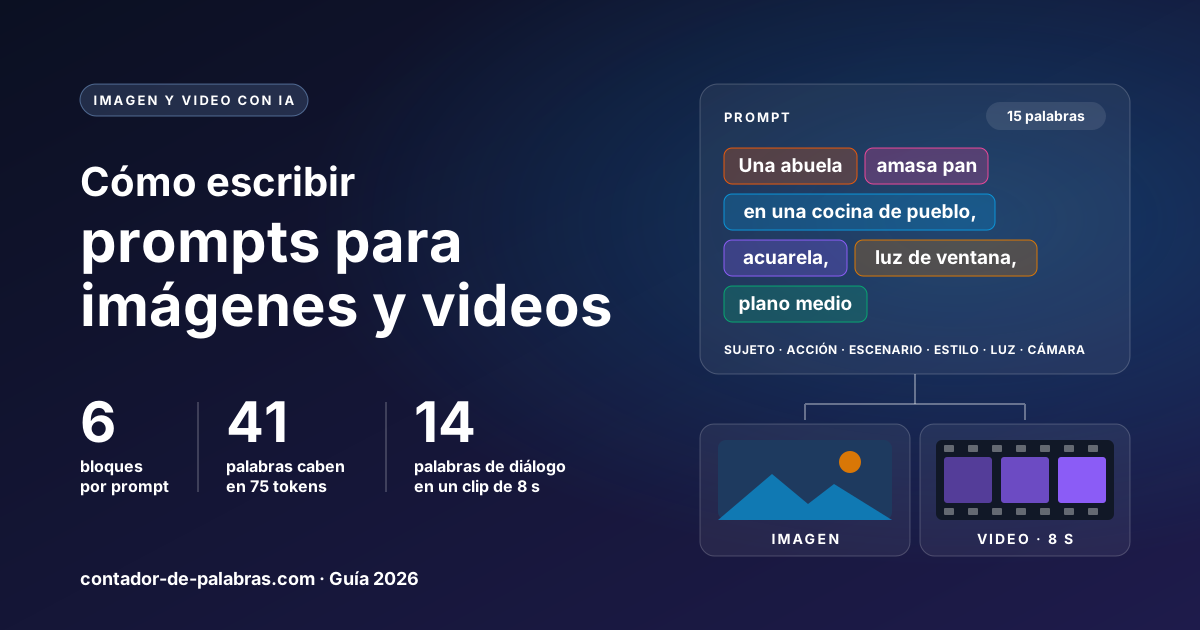
Un prompt para generar imágenes o videos con IA no es una búsqueda en Google ni una orden a un asistente: es la descripción de lo que vería una cámara. Esta guía explica cómo se construye esa descripción en seis bloques, cuántas palabras conviene usar —con una medición propia de cuánto «cuesta» el español frente al inglés— y qué cambia cuando lo que pides es un video con diálogo.
Un buen prompt describe, por este orden, sujeto, acción, escenario, estilo, luz y cámara, en 15 a 60 palabras para imagen y 40 a 90 para video. Con los modelos actuales puedes escribir en español; solo en los que leen con CLIP (Stable Diffusion 1.5 y SDXL) el español se queda en unas 41 palabras útiles frente a 63 en inglés. Para el diálogo, calcula unas 14 palabras por cada clip de 8 segundos.
Anatomía de un prompt: los seis bloques
La forma más fiable de no olvidar nada es pensar el prompt como seis preguntas, en este orden: quién, qué hace, dónde, cómo se ve, con qué luz y desde dónde se mira. No es una plantilla inventada: la guía oficial de Google para Veo descompone los prompts en esos mismos elementos —sujeto, acción, contexto, estilo, cámara e iluminación— y añade el sonido para el video.
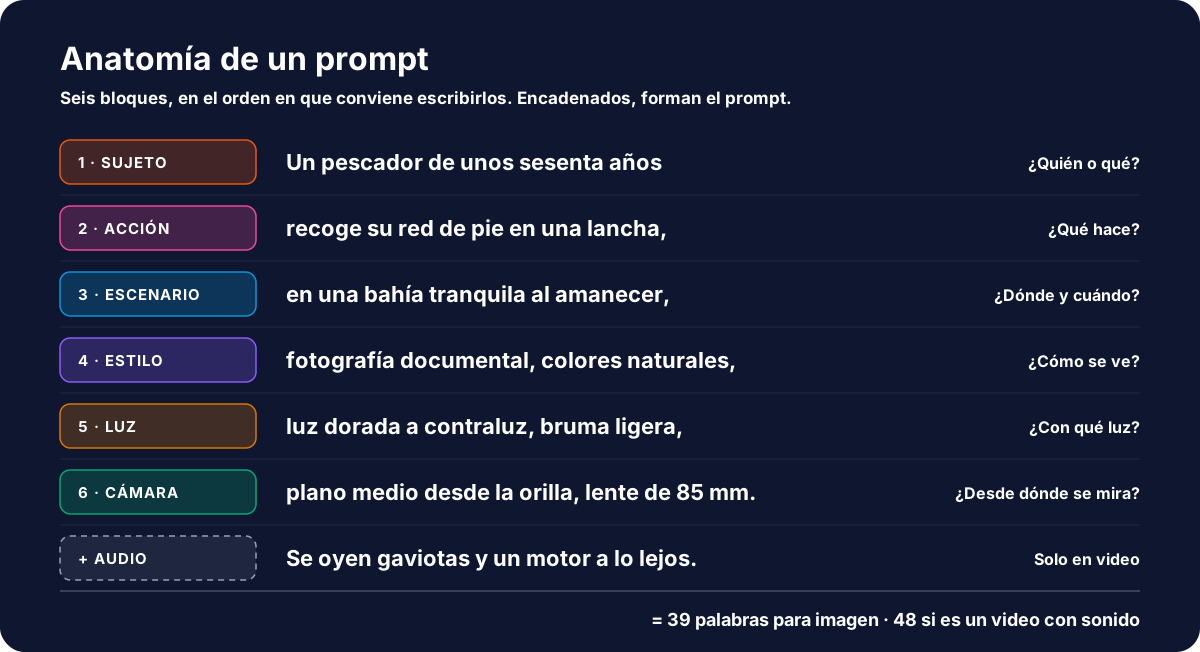
- Sujeto. Sé concreto con lo que se ve, no con lo que se sabe. «Un pescador de unos sesenta años con gorra de lana» funciona; «un pescador con mucha experiencia» no, porque la experiencia no se fotografía.
- Acción. Un verbo principal. En una imagen fija la acción decide la postura; en un video es lo que ocurre durante el clip.
- Escenario. Lugar y momento juntos: «en una bahía tranquila al amanecer» resuelve a la vez el fondo y la hora.
- Estilo. El medio —fotografía documental, acuarela, render 3D, ilustración vectorial— pesa más que adjetivos como «bonito» o «impresionante», que no describen nada.
- Luz. Dirección y calidad: contraluz, luz lateral de ventana, mediodía duro, hora azul.
- Cámara. Tipo de plano (general, medio, primer plano), ángulo (picado, contrapicado) y, si quieres, la óptica: «lente de 85 mm», «gran angular».
¿Por qué ese orden? Porque lo primero que escribes es lo último que se pierde. Los modelos con un tope de texto, como los que usan CLIP, cortan por el final: si el prompt se pasa, desaparecen la luz y la cámara, no el sujeto.
Cuántas palabras debe tener un prompt
Los modelos no leen palabras, leen tokens: trozos de palabra sacados de un vocabulario fijo. «Mountain» es un token; «montaña» son tres (mon · ta · ña). Por eso la extensión razonable de un prompt depende de quién lo lea:
- CLIP, el codificador de texto de Stable Diffusion 1.5, 2.x y SDXL, lee como máximo 77 tokens: 75 útiles más dos marcas de inicio y fin. De ahí sale la regla de «no pases de 75 tokens» que circula por foros y tutoriales.
- T5, el codificador que usa Flux, admite 512 tokens en su configuración por defecto.
- La API de imágenes de OpenAI acepta prompts de hasta 32.000 caracteres.
Con límites así, el tope ya no lo pone el modelo: lo pone la atención. Cada adjetivo de más compite con los importantes, y un prompt de 200 palabras suele contradecirse en algún punto (pide «luz suave» al principio y «sombras marcadas» al final). Como referencia, los ejemplos de la guía oficial de Veo tienen 55 y 62 palabras. Estos son los rangos que recomendamos:
| Tipo de prompt | Palabras | Qué priorizar |
|---|---|---|
| Imagen sencilla (un objeto, un estilo) | 15 – 30 | Sujeto, estilo y fondo |
| Escena o retrato | 30 – 60 | Los seis bloques |
| Video sin diálogo (un plano de 5–8 s) | 40 – 70 | Acción y movimiento de cámara |
| Video con diálogo y sonido | 50 – 90 | Diálogo corto y sonido en frases aparte |
| Modelos con CLIP, en español | ≤ 40 | Lo esencial primero: el resto se corta |
Para saber en qué punto está tu prompt, pégalo en el contador de palabras. Si la herramienta que usas limita por caracteres en vez de por palabras, el contador de caracteres te da la cifra exacta, espacios incluidos.
¿En español o en inglés?
Es la duda más repetida entre quienes escriben prompts en español, y la respuesta honesta es que depende del modelo. Para tener un dato en lugar de una impresión, medimos 12 prompts paralelos —el mismo contenido en inglés, español y portugués— con el tokenizador oficial de CLIP, el del repositorio de OpenAI, comprobado antes contra sus identificadores publicados.
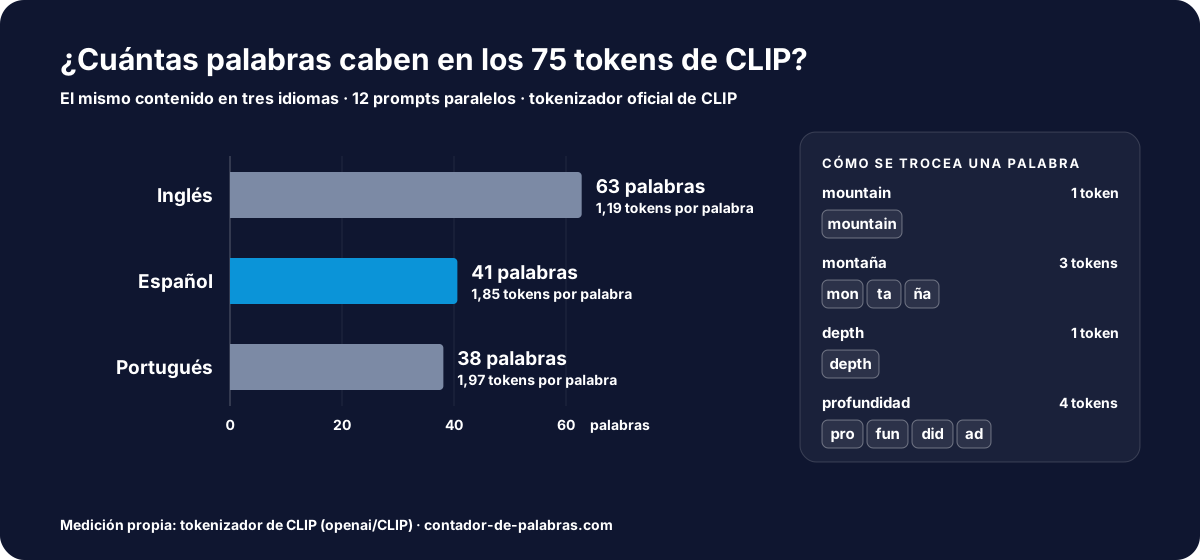
En inglés cada palabra ocupa 1,19 tokens de media; en español, 1,85. El mismo prompt en español gasta 1,66 veces más tokens, de modo que en los 75 útiles caben unas 63 palabras en inglés y solo 41 en español. No es que el español sea mucho más largo: el corpus tenía apenas un 7% más de palabras en español. Es que el vocabulario de CLIP se construyó con texto mayoritariamente inglés y trocea lo que no reconoce. «Profundidad» son cuatro tokens y «depth», uno. Las letras con tilde y la ñ ocupan dos bytes y el vocabulario las ha visto mucho menos: en «cinematográfica», la á se queda sola como token.
La descompensación viene de los datos. LAION-5B, el conjunto público con el que se entrenaron muchos modelos abiertos, reúne 5.850 millones de pares imagen-texto: 2.300 millones en inglés y 2.200 millones repartidos entre más de cien idiomas. Qué hacer con este dato:
- Con modelos basados en grandes modelos de lenguaje, como Nano Banana (Google) o GPT Image (OpenAI), escribe en español. Están entrenados en muchos idiomas y traducir te hace perder matices: un tianguis no es un «street market» cualquiera.
- Con Stable Diffusion 1.5 o SDXL, o cuando un término no surta efecto, pásalo al inglés. Funciona sobre todo con el vocabulario técnico de foto y cine («shallow depth of field», «dolly in»), el que más aparece en los pies de foto con los que se entrenaron.
- Lo mixto es válido: la escena en español y dos o tres términos técnicos en inglés.
Prompts de video: movimiento, cámara y sonido
Un prompt de video es un prompt de imagen con tiempo. Todo lo anterior sigue valiendo, y se suman tres preguntas: qué se mueve, cómo se mueve la cámara y qué se oye.
- Una acción principal por clip. Los modelos actuales generan clips de entre 4 y 15 segundos. En ese tiempo cabe un gesto o un desplazamiento, no tres acciones encadenadas. Si necesitas más, genera varios clips y móntalos.
- Movimiento de cámara con nombre propio. La guía de Veo recoge el vocabulario clásico del cine: plano fijo, panorámica, travelling, dolly (la cámara se acerca o se aleja físicamente), grúa, cámara en mano, plano en arco alrededor del sujeto. «La cámara avanza despacio hacia ella» es más preciso que «toma dinámica».
- El sonido, en frases aparte. Google recomienda describir el audio en oraciones separadas: efectos («el timbre de un teléfono»), ambiente («tráfico lejano y sirenas») y diálogo.
- El diálogo, después de dos puntos. Los ejemplos oficiales escriben quién habla y, tras «dice:», la frase. Añade acento y tono si importan: «con acento mexicano y tono cansado», «español de España, voz grave». La propia guía de Google usa el recurso con «una voz en off con un acento británico pulido».
- Prompt negativo sin «no». Si el modelo admite prompt negativo, enumera lo que no quieres («pared, marco») en lugar de escribir «no muestres paredes».
Cuánto diálogo cabe en un clip
Aquí el contador de palabras vuelve a ser la herramienta clave. Una locución natural va a 130–150 palabras por minuto, es decir, entre 2,2 y 2,5 palabras por segundo. Pero un clip no es todo diálogo: el plano necesita arrancar y cerrar. Dejando un segundo y medio de margen y calculando a 130 palabras por minuto, salen estas cifras:
| Duración del clip | Diálogo cómodo | Techo (150 PPM) |
|---|---|---|
| 5 segundos | ~7 palabras | 12 |
| 8 segundos (un clip de Veo 3.1) | ~14 palabras | 20 |
| 10 segundos | ~18 palabras | 25 |
| 15 segundos | ~29 palabras | 37 |
En español conviene quedarse en la columna cómoda: sus palabras son algo más largas que las inglesas y, a igual claridad, se dicen menos por minuto. Si el guion no cabe, no aceleres la voz; recorta la frase o reparte el diálogo en dos clips.
Texto dentro de la imagen: tildes, eñes y signos de apertura
Pedir un cartel, una portada o una miniatura con texto es donde más se nota la calidad de un modelo. Tres reglas que ahorran intentos:
- El texto exacto, entre comillas, y dónde va. «Titular en letras gruesas arriba con el texto “¡Pan recién hecho cada mañana!”» deja menos margen que «un cartel de panadería con un eslogan».
- Corto. Cada palabra añadida es una ocasión más de error. Para titulares, quédate en cinco o seis palabras; el resto del texto ponlo después, en un editor.
- Revisa lo que el inglés no tiene. Un modelo entrenado sobre todo con texto en inglés no tiene por qué saber que la ñ no es una n con adorno, que la tilde cambia la palabra (papa no es papá) ni que en español la pregunta se abre con ¿. Son las tres cosas que hay que mirar letra a letra antes de publicar.
Si tras tres o cuatro intentos el texto sigue saliendo mal, cambia de estrategia: genera la imagen sin texto, dejando espacio vacío donde iría, y añade las letras tú. Es más rápido que perseguir la tilde perfecta.
Prueba el mismo prompt en varios modelos
Cuando un resultado no se parece a lo que pediste, la tentación es reescribir el prompt. Antes conviene descartar la otra posibilidad: que el prompt esté bien y el modelo no sea el adecuado. Cada modelo tiene su carácter. Unos siguen al pie de la letra las descripciones largas, otros destacan con el texto dentro de la imagen y otros con el movimiento de cámara, y el mismo prompt de 40 palabras puede salir perfecto en uno y torcido en otro.
La comprobación es barata si tienes los modelos en un mismo sitio. Un generador de imágenes y videos con IA como Anyscene reúne modelos de imagen como Nano Banana Pro, GPT Image 2.5, Seedream 5.0 o Flux 2 y de video como Kling 3.0, Seedance 2.5 o Veo 3.1 con un único saldo de créditos, así que lanzar el mismo texto en tres modelos es cuestión de cambiar un desplegable. Al registrarte recibes créditos gratuitos para empezar. Si tu imagen lleva texto, incluye en la ronda un modelo pensado para tipografía; si es un video con diálogo, uno que genere sonido.
El método que mejor funciona:
- Fija el prompt y pruébalo tal cual en tres modelos.
- Si los tres fallan en lo mismo, el problema es el prompt: cambia un solo bloque y repite.
- Si solo falla uno, quédate con el que acierta y no toques el texto.
- Guarda cada versión con su recuento de palabras. Al cabo de unas semanas verás en qué rango te funcionan mejor tus prompts.
Tres plantillas para copiar
Cada una sigue el orden de los seis bloques y cae dentro de su rango. Cambia los datos entre los bloques y conserva la estructura.
Fíjate en el diálogo del tercer ejemplo: cuatro palabras en un clip que admite catorce. Una frase corta deja que el gesto y el sonido hagan el resto, y casi siempre resulta más natural que llenar los ocho segundos de texto.
Preguntas frecuentes
¿Cuántas palabras debe tener un prompt para generar imágenes?
¿Es mejor escribir los prompts en inglés?
¿Qué significa el límite de 75 tokens?
¿Cuánto diálogo cabe en un video de 8 segundos?
¿Cómo consigo que la IA escriba bien la ñ y las tildes?
¿Qué es un prompt negativo?
Herramientas y artículos relacionados
Contador de Palabras
Mide la extensión de tu prompt.
Abrir →Anyscene
Imágenes y videos con IA en varios modelos.
Probar →Contador de Caracteres
Para límites por caracteres.
Abrir →Palabras por minuto de audio
El ritmo detrás del diálogo.
Leer →Sigue: cuántas palabras son un minuto de audio · límites de caracteres en redes sociales · cómo escribir un cuento corto.