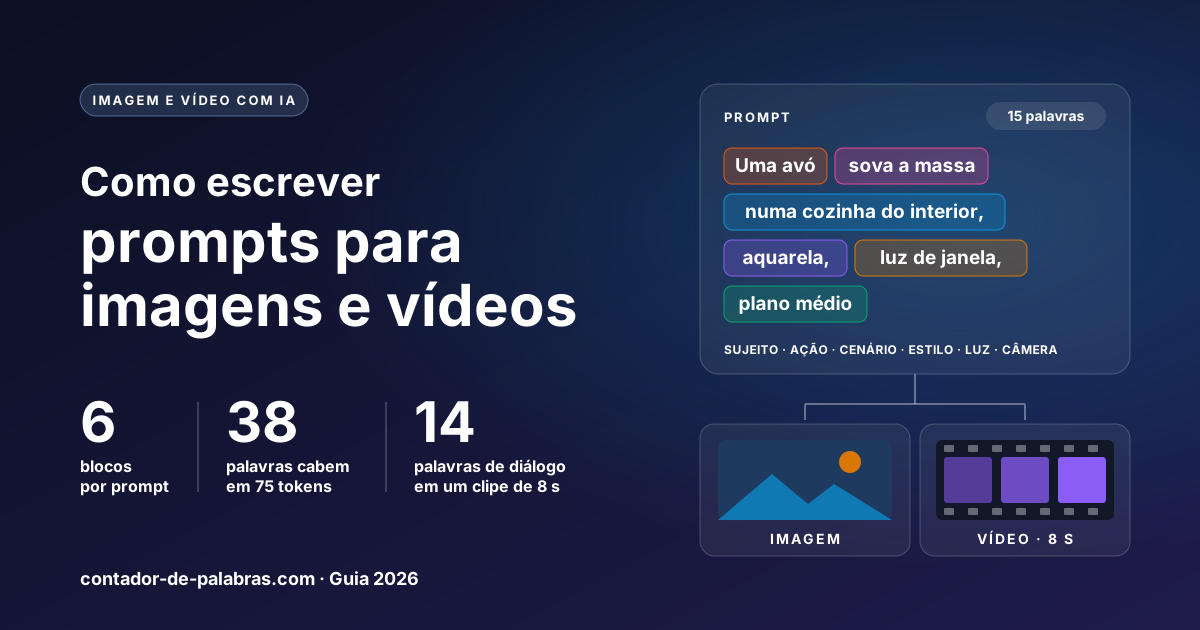
Um prompt para gerar imagens ou vídeos com IA não é uma busca no Google nem uma ordem para um assistente: é a descrição do que uma câmera veria. Este guia mostra como montar essa descrição em seis blocos, quantas palavras usar —com uma medição própria de quanto o português “custa” em relação ao inglês— e o que muda quando você pede um vídeo com fala.
Um bom prompt descreve, nesta ordem, sujeito, ação, cenário, estilo, luz e câmera, em 15 a 60 palavras para imagem e 40 a 90 para vídeo. Com os modelos atuais você pode escrever em português; só nos que leem com o CLIP (Stable Diffusion 1.5 e SDXL) o português fica em umas 38 palavras úteis, contra 63 em inglês. Para o diálogo, conte cerca de 14 palavras por clipe de 8 segundos.
Anatomia de um prompt: os seis blocos
O jeito mais seguro de não esquecer nada é pensar o prompt como seis perguntas, nesta ordem: quem, fazendo o quê, onde, com que aparência, com que luz e visto de onde. Não é um modelo inventado: o guia oficial do Google para o Veo divide os prompts nesses mesmos elementos —sujeito, ação, contexto, estilo, câmera e iluminação— e acrescenta o som para vídeo.
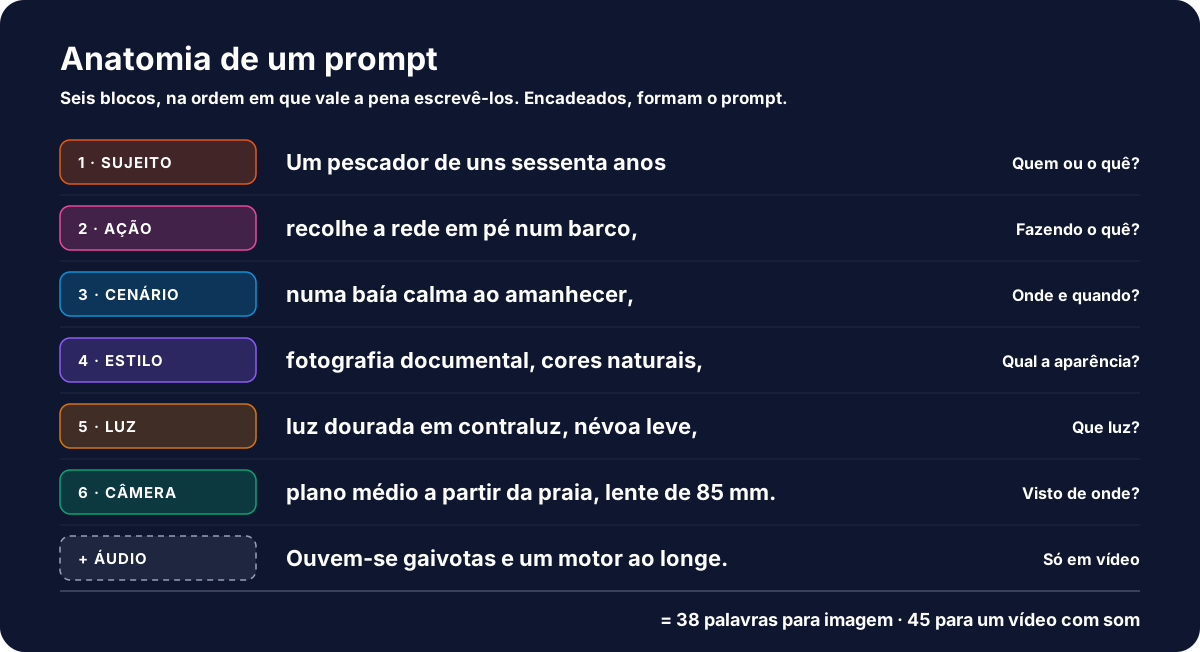
- Sujeito. Seja concreto com o que se vê, não com o que se sabe. “Um pescador de uns sessenta anos de boné de lã” funciona; “um pescador muito experiente” não, porque experiência não aparece na foto.
- Ação. Um verbo principal. Na imagem parada a ação define a postura; no vídeo, é o que acontece durante o clipe.
- Cenário. Lugar e momento juntos: “numa baía calma ao amanhecer” resolve de uma vez o fundo e a hora.
- Estilo. O meio —fotografia documental, aquarela, render 3D, ilustração vetorial— pesa mais do que adjetivos como “lindo” ou “incrível”, que não descrevem nada.
- Luz. Direção e qualidade: contraluz, luz lateral de janela, sol a pino, hora azul.
- Câmera. Tipo de plano (geral, médio, close), ângulo (plongée, contra-plongée) e, se quiser, a lente: “lente de 85 mm”, “grande angular”.
Por que essa ordem? Porque o que você escreve primeiro é o que sobrevive. Os modelos com teto de texto, como os que usam o CLIP, cortam pelo final: se o prompt passar do limite, somem a luz e a câmera, não o sujeito.
Quantas palavras deve ter um prompt
Os modelos não leem palavras, leem tokens: pedaços de palavra tirados de um vocabulário fixo. “Lighting” é um token; “iluminação” são cinco (ilu · min · a · ç · ão). Por isso o tamanho razoável de um prompt depende de quem vai lê-lo:
- O CLIP, codificador de texto do Stable Diffusion 1.5, 2.x e SDXL, lê no máximo 77 tokens: 75 úteis mais duas marcas de início e fim. Daí vem a regra do “não passe de 75 tokens” que circula em fóruns e tutoriais.
- O T5, codificador usado pelo Flux, aceita 512 tokens na configuração padrão.
- A API de imagens da OpenAI aceita prompts de até 32.000 caracteres.
Com limites assim, o teto já não é o modelo: é a atenção. Cada adjetivo a mais disputa espaço com os importantes, e um prompt de 200 palavras costuma se contradizer em algum ponto (pede “luz suave” no começo e “sombras marcadas” no fim). Como referência, os exemplos do guia oficial do Veo têm 55 e 62 palavras. Estas são as faixas que recomendamos:
| Tipo de prompt | Palavras | O que priorizar |
|---|---|---|
| Imagem simples (um objeto, um estilo) | 15 – 30 | Sujeito, estilo e fundo |
| Cena ou retrato | 30 – 60 | Os seis blocos |
| Vídeo sem diálogo (um plano de 5–8 s) | 40 – 70 | Ação e movimento de câmera |
| Vídeo com diálogo e som | 50 – 90 | Fala curta e som em frases à parte |
| Modelos com CLIP, em português | ≤ 35 | O essencial primeiro: o resto é cortado |
Para saber onde o seu prompt está, cole-o no contador de palavras. Se a ferramenta que você usa limita por caracteres e não por palavras, o contador de caracteres dá o número exato, com espaços.
Em português ou em inglês?
É a dúvida mais comum de quem escreve prompts em português, e a resposta honesta é que depende do modelo. Para ter um dado em vez de uma impressão, medimos 12 prompts paralelos —o mesmo conteúdo em inglês, espanhol e português— com o tokenizador oficial do CLIP, o do repositório da OpenAI, conferido antes com os identificadores que ela publica.
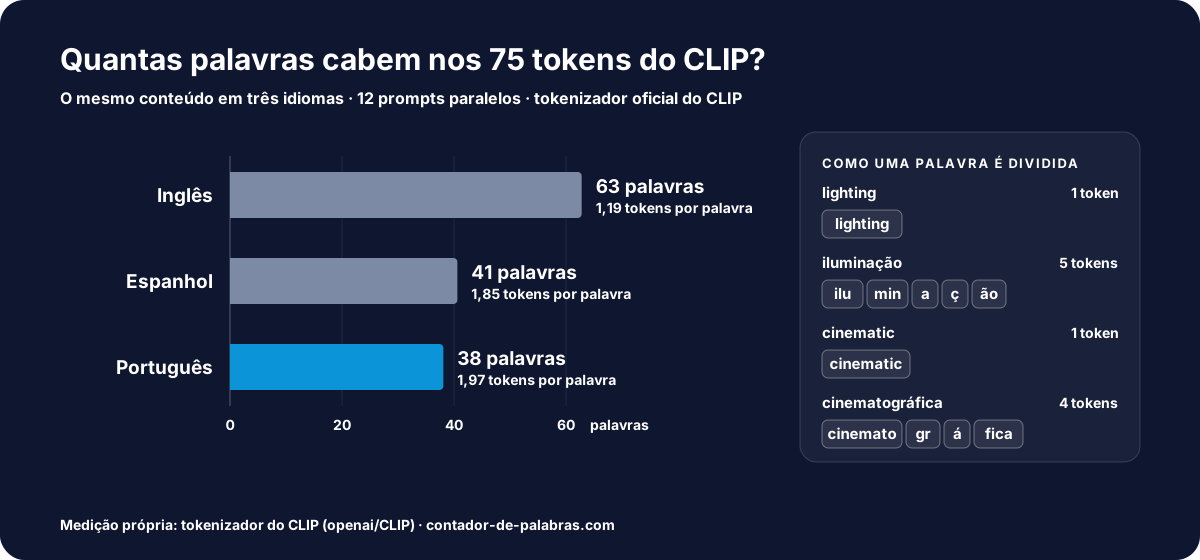
Em inglês cada palavra ocupa 1,19 token em média; em português, 1,97, o valor mais alto dos três idiomas. O mesmo prompt em português gasta 1,75 vez mais tokens, de modo que nos 75 úteis cabem cerca de 63 palavras em inglês e só 38 em português. Não é que o português seja muito mais longo: o corpus tinha só 6% mais palavras em português. É que o vocabulário do CLIP foi montado com texto majoritariamente em inglês e quebra o que não reconhece. O ç e as vogais com til ocupam dois bytes e quase não aparecem nesse vocabulário: em “iluminação”, o ç e o “ão” viram tokens separados.
O desequilíbrio vem dos dados. O LAION-5B, conjunto público usado para treinar muitos modelos abertos, reúne 5,85 bilhões de pares imagem-texto: 2,3 bilhões em inglês e 2,2 bilhões espalhados por mais de cem idiomas. O que fazer com essa informação:
- Com modelos baseados em grandes modelos de linguagem, como o Nano Banana (Google) ou o GPT Image (OpenAI), escreva em português. Eles foram treinados em muitos idiomas, e traduzir faz perder nuances: uma feira livre não é um “street market” qualquer.
- Com Stable Diffusion 1.5 ou SDXL, ou quando um termo não fizer efeito, passe-o para o inglês. Funciona sobretudo com o vocabulário técnico de foto e cinema (“shallow depth of field”, “dolly in”), o mais frequente nas legendas usadas no treino.
- Misturar vale: a cena em português e dois ou três termos técnicos em inglês.
Prompts de vídeo: movimento, câmera e som
Um prompt de vídeo é um prompt de imagem com tempo. Tudo o que vimos continua valendo, e entram mais três perguntas: o que se move, como a câmera se move e o que se ouve.
- Uma ação principal por clipe. Os modelos atuais geram clipes de 4 a 15 segundos. Nesse tempo cabe um gesto ou um deslocamento, não três ações encadeadas. Se precisar de mais, gere vários clipes e monte depois.
- Movimento de câmera com nome. O guia do Veo usa o vocabulário clássico do cinema: plano fixo, panorâmica, travelling, dolly (a câmera se aproxima ou se afasta fisicamente), grua, câmera na mão, plano em arco ao redor do sujeito. “A câmera avança devagar até ela” é mais preciso que “tomada dinâmica”.
- O som em frases separadas. O Google recomenda descrever o áudio em orações à parte: efeitos (“um telefone tocando”), ambiente (“trânsito ao longe e sirenes”) e diálogo.
- O diálogo depois de dois-pontos. Os exemplos oficiais dizem quem fala e, depois de “diz:”, a frase. Acrescente sotaque e tom quando importarem. O português tem duas grandes variantes, então diga qual quer: “em português do Brasil, com sotaque carioca”, “sotaque paulistano, voz grave”. O próprio guia do Google usa o recurso com “uma narração com um sotaque britânico refinado”.
- Prompt negativo sem “não”. Se o modelo aceita prompt negativo, liste o que você não quer (“parede, moldura”) em vez de escrever “não mostre paredes”.
Quanto diálogo cabe em um clipe
Aqui o contador de palavras volta a ser a ferramenta principal. Uma narração natural vai a 130–150 palavras por minuto, ou seja, entre 2,2 e 2,5 palavras por segundo. Mas um clipe não é só fala: o plano precisa de um tempo para começar e fechar. Deixando um segundo e meio de margem e calculando a 130 palavras por minuto, chegamos a estes números:
| Duração do clipe | Diálogo confortável | Teto (150 PPM) |
|---|---|---|
| 5 segundos | ~7 palavras | 12 |
| 8 segundos (um clipe do Veo 3.1) | ~14 palavras | 20 |
| 10 segundos | ~18 palavras | 25 |
| 15 segundos | ~29 palavras | 37 |
Fique na coluna confortável. Se a fala não couber, não peça uma voz mais rápida: corte a frase ou divida o diálogo em dois clipes. Para Reels e TikTok, em que cada clipe costuma ser uma cena, isso também deixa a edição mais fácil.
Texto dentro da imagem: cedilha, til e acentos
Pedir um post, uma capa ou uma thumbnail com texto é onde a qualidade de um modelo mais aparece. Três regras poupam tentativas:
- O texto exato, entre aspas, e onde ele fica. “Título em letras grossas no topo com o texto ‘PROMOÇÃO DE INVERNO’” deixa menos margem para erro do que “um post de padaria com um slogan”.
- Curto. Cada palavra a mais é mais uma chance de erro. Em títulos, fique em cinco ou seis palavras; o resto do texto, coloque depois em um editor.
- Confira o que o inglês não tem. Um modelo treinado sobretudo com texto em inglês não tem por que saber que o ç não é um c com enfeite, que o til muda a palavra (pao não existe, pão sim) nem que, em português, os acentos continuam obrigatórios nas maiúsculas: “PROMOÇÃO”, nunca “PROMOCAO”. Leia letra por letra antes de publicar.
Se depois de três ou quatro tentativas o texto continuar saindo errado, mude de estratégia: gere a imagem sem texto, deixando o espaço vazio, e coloque as letras você mesmo. É mais rápido do que correr atrás do til perfeito.
Teste o mesmo prompt em vários modelos
Quando o resultado não sai como você pediu, a tentação é reescrever o prompt. Antes, vale descartar a outra possibilidade: o prompt está bom e o modelo é que não é o certo. Cada modelo tem seu jeito. Uns seguem à risca descrições longas, outros se destacam com texto dentro da imagem e outros com movimento de câmera, e o mesmo prompt de 40 palavras pode sair perfeito em um e torto em outro.
Essa verificação sai barata quando os modelos estão no mesmo lugar. Um gerador de imagens e vídeos com IA como o Anyscene reúne modelos de imagem como Nano Banana Pro, GPT Image 2.5, Seedream 5.0 e Flux 2 e de vídeo como Kling 3.0, Seedance 2.5 e Veo 3.1 com um único saldo de créditos, então rodar o mesmo texto em três modelos é questão de trocar um menu. Ao criar a conta você recebe créditos grátis para começar. Se a imagem leva texto, inclua na rodada um modelo voltado para tipografia; se é um vídeo com fala, um que gere som.
O método que funciona melhor:
- Fixe o prompt e rode-o sem mudanças em três modelos.
- Se os três erram do mesmo jeito, o problema é o prompt: mude um único bloco e repita.
- Se só um erra, fique com o que acertou e não mexa no texto.
- Guarde cada versão com a contagem de palavras. Em algumas semanas você vai ver em que faixa os seus prompts funcionam melhor.
Três modelos de prompt para copiar
Cada um segue a ordem dos seis blocos e fica dentro da sua faixa. Troque os detalhes e mantenha a estrutura.
Repare no diálogo do terceiro exemplo: três palavras em um clipe que comporta catorze. Uma fala curta deixa o gesto e o som fazerem o resto e quase sempre soa mais natural do que encher os oito segundos de texto.
Perguntas frequentes
Quantas palavras deve ter um prompt para gerar imagens?
É melhor escrever os prompts em inglês?
O que significa o limite de 75 tokens?
Quanto diálogo cabe em um vídeo de 8 segundos?
Como faço a IA escrever certo o ç e o til?
O que é um prompt negativo?
Ferramentas e artigos relacionados
Contador de Palavras
Meça o tamanho do seu prompt.
Abrir →Anyscene
Imagens e vídeos com IA em vários modelos.
Testar →Letras com Acento
Ç, til e acentos para copiar.
Abrir →Palavras por minuto de áudio
O ritmo por trás do diálogo.
Ler →Veja também: quantas palavras são um minuto de áudio · limites de caracteres nas redes sociais · como escrever um conto.